Le scraping de LinkedIn est-il légal ? Ce n'est pas un délit en soi, mais ce n'est pas sans risque non plus. Aux États-Unis, le scraping de pages que tout le monde peut ouvrir n'a pas été jugé contraire au Computer Fraud and Abuse Act, mais il enfreint le contrat d'utilisation de LinkedIn et expose à des blocages de compte ou à des poursuites. Dans l'UE, chaque profil est une donnée personnelle, le RGPD s'applique donc pleinement : il vous faut une base juridique, vous devez informer la personne, vous ne pouvez conserver les données que le temps de la finalité, et vous devez cesser si elle s'y oppose. "C'était public" n'est pas une défense.
Réponse courte : trois niveaux distincts, trois réponses distinctes
La plupart des articles demandent "légal ou illégal ?" comme s'il n'existait qu'une seule règle. Il y en a trois, appliquées par des acteurs différents, et elles donnent des réponses différentes pour le même acte.
| Niveau | La question | Profils publics, scrapés | Conséquence typique |
|---|---|---|---|
| Droit pénal / droit d'accès | Avez-vous forcé l'accès à un système protégé ? | Aux États-Unis, probablement pas pour des pages que tout le monde peut ouvrir (hiQ, Van Buren) | Faible pour les pages publiques ; plus élevée en cas de connexion, de faux comptes et de contournement de blocages |
| Contrat (contrat d'utilisation de LinkedIn) | Avez-vous accepté de ne pas scraper ? | Oui, si vous avez un compte : bots, crawlers et extensions sont interdits | Compte restreint, mises en demeure, demandes de dommages et intérêts contre les scrapers commerciaux |
| Protection des données (RGPD) | Avez-vous une base pour traiter les données de ces personnes ? | Ce sont des données personnelles. L'intérêt légitime peut fonctionner, sous conditions | Amendes jusqu'à 20 millions € ou 4 % du chiffre d'affaires, ordres de suppression, demandes de dommages et intérêts |
Un recruteur qui lit des profils dans un navigateur reste du bon côté des trois niveaux si le processus est documenté. Une équipe qui exporte des milliers de profils avec une extension de navigateur est exposée sur les trois à la fois.
Le scraping de LinkedIn est-il un délit aux États-Unis ?
Le débat américain porte sur le Computer Fraud and Abuse Act (CFAA). Dans Van Buren v. United States (3 juin 2021), la Cour suprême a interprété le CFAA de façon restrictive : il couvre l'accès à des parties d'un ordinateur qui vous sont interdites, pas l'usage abusif d'informations que vous aviez le droit de voir (décision). En appliquant cette ligne, le Ninth Circuit a jugé le 18 avril 2022 dans hiQ v. LinkedIn que le scraping de données sur des pages publiques, sans connexion, ne constitue probablement pas un accès "sans autorisation" (décision).
C'est moins un feu vert qu'il n'y paraît. La cour a elle-même noté que les propriétaires de sites ne sont "pas sans recours" au titre d'autres lois, et l'affaire s'est terminée en décembre 2022 par un jugement sur accord de 500 000 $ contre hiQ et une injonction permanente de cesser le scraping et de supprimer les données (synthèse de Proskauer). La décision porte sur les pages publiques ; elle ne dit rien des connexions, des faux comptes ni du droit européen de la protection des données.
Que dit la règle propre de LinkedIn, et que vous arrive-t-il ?
Le centre d'aide de LinkedIn indique que les crawlers, bots, plug-ins et extensions de navigateur qui scrapent le site ou automatisent l'activité ne sont pas autorisés, et que les membres qui utilisent de tels outils enfreignent le contrat d'utilisation ; les conséquences vont de la restriction du compte à des outils qui cessent de fonctionner (centre d'aide LinkedIn, état en octobre 2026). Pour vous, recruteur, c'est le coût réel le plus probable : un poste recruteur restreint en pleine recherche.
Pour les scrapers commerciaux, le coût est plus élevé. Le 24 janvier 2025, LinkedIn a poursuivi Proxycurl pour avoir scrapé des profils et créé de faux comptes (annonce de LinkedIn du 24 janvier 2025) et a depuis annoncé que l'affaire était réglée. Les outils construits sur ce type de données peuvent disparaître du jour au lendemain, en emportant votre processus avec eux.
Le RGPD s'applique-t-il aux profils LinkedIn publics ?
Oui. Un nom, un intitulé de poste, un employeur et une photo sont des données personnelles, que la personne les ait rendus visibles ou non. Le RGPD s'applique à quiconque cible des personnes dans l'UE, où que se trouve le recruteur (texte du RGPD). Quatre obligations comptent en sourcing :
- Base juridique. La candidate habituelle est l'intérêt légitime au titre de l'art. 6, par. 1, point f) : vous avez un intérêt réel (pourvoir un poste), le traitement est nécessaire, et les intérêts de la personne ne prévalent pas sur les vôtres. Consignez cette mise en balance par poste. Une personne dont le profil signale une ouverture aux opportunités est plus facile à justifier que quelqu'un qui ne s'attendait jamais à être contacté.
- Information. Si vous n'avez pas collecté les données auprès de la personne, l'art. 14 vous oblige à lui dire qui vous êtes, pourquoi vous détenez les données, d'où elles viennent et de quels droits elle dispose, au plus tard dans un délai d'un mois, ou dès le premier message si vous utilisez les données pour la contacter.
- Conservation. Ne conservez les données que le temps de la finalité. Les profils qui n'ont jamais été contactés ne devraient pas rester des années dans une base.
- Opposition. Si quelqu'un s'oppose (art. 21), cessez le traitement pour cette finalité et veillez à ce que l'arrêt atteigne chaque outil et chaque liste qui détient la personne.
Ce que les autorités ont réellement fait
Les sanctions ne concernent pas des recruteurs, mais elles montrent comment les autorités comprennent le mot "public" :
- KASPR (France, 5 décembre 2024) : la CNIL a infligé 240 000 € d'amende à l'éditeur d'une extension de navigateur qui révèle les coordonnées issues de profils LinkedIn. Il collectait des coordonnées de personnes qui avaient restreint leur visibilité, ce qui dépassait ce à quoi elles pouvaient raisonnablement s'attendre ; il conservait les données cinq ans à partir de chaque mise à jour ; et il n'a informé les personnes qu'environ quatre ans après le lancement (décision de la CNIL).
- Clearview AI (Pays-Bas, 16 mai 2024) : 30,5 millions € pour avoir constitué une base de données sans base juridique et sans informer les personnes concernées (actualité du CEPD). Il s'agissait d'images de visages, pas de CV, mais le principe est le même.
- Scraping de Facebook (Allemagne, 18 novembre 2024) : la Cour fédérale de justice a jugé que même une perte de contrôle sur des données personnelles peut constituer un dommage au sens de l'art. 82 du RGPD et a indiqué environ 100 € pour la simple perte de contrôle (communiqué de presse de la BGH). Cette affaire visait la plateforme dont les données avaient été scrapées, mais elle montre que les tribunaux comptent le contrôle, pas l'usage abusif.
Qu'est-ce qui change en Allemagne, en Autriche et en Suisse ?
La logique du RGPD est la même, mais les règles de prise de contact ajoutent un second test. En Allemagne, les approches par e-mail et par téléphone relèvent du § 7 UWG, plus strict que le RGPD ; un message LinkedIn et un e-mail ne sont pas traités de la même façon. Les profils XING suivent la même logique que LinkedIn : la visibilité publique ne remplace ni une base juridique ni l'information de l'art. 14. Notre guide du sourcing actif et du RGPD détaille les règles de prise de contact.
Comment faire du sourcing sans risque de scraping ? Étape par étape
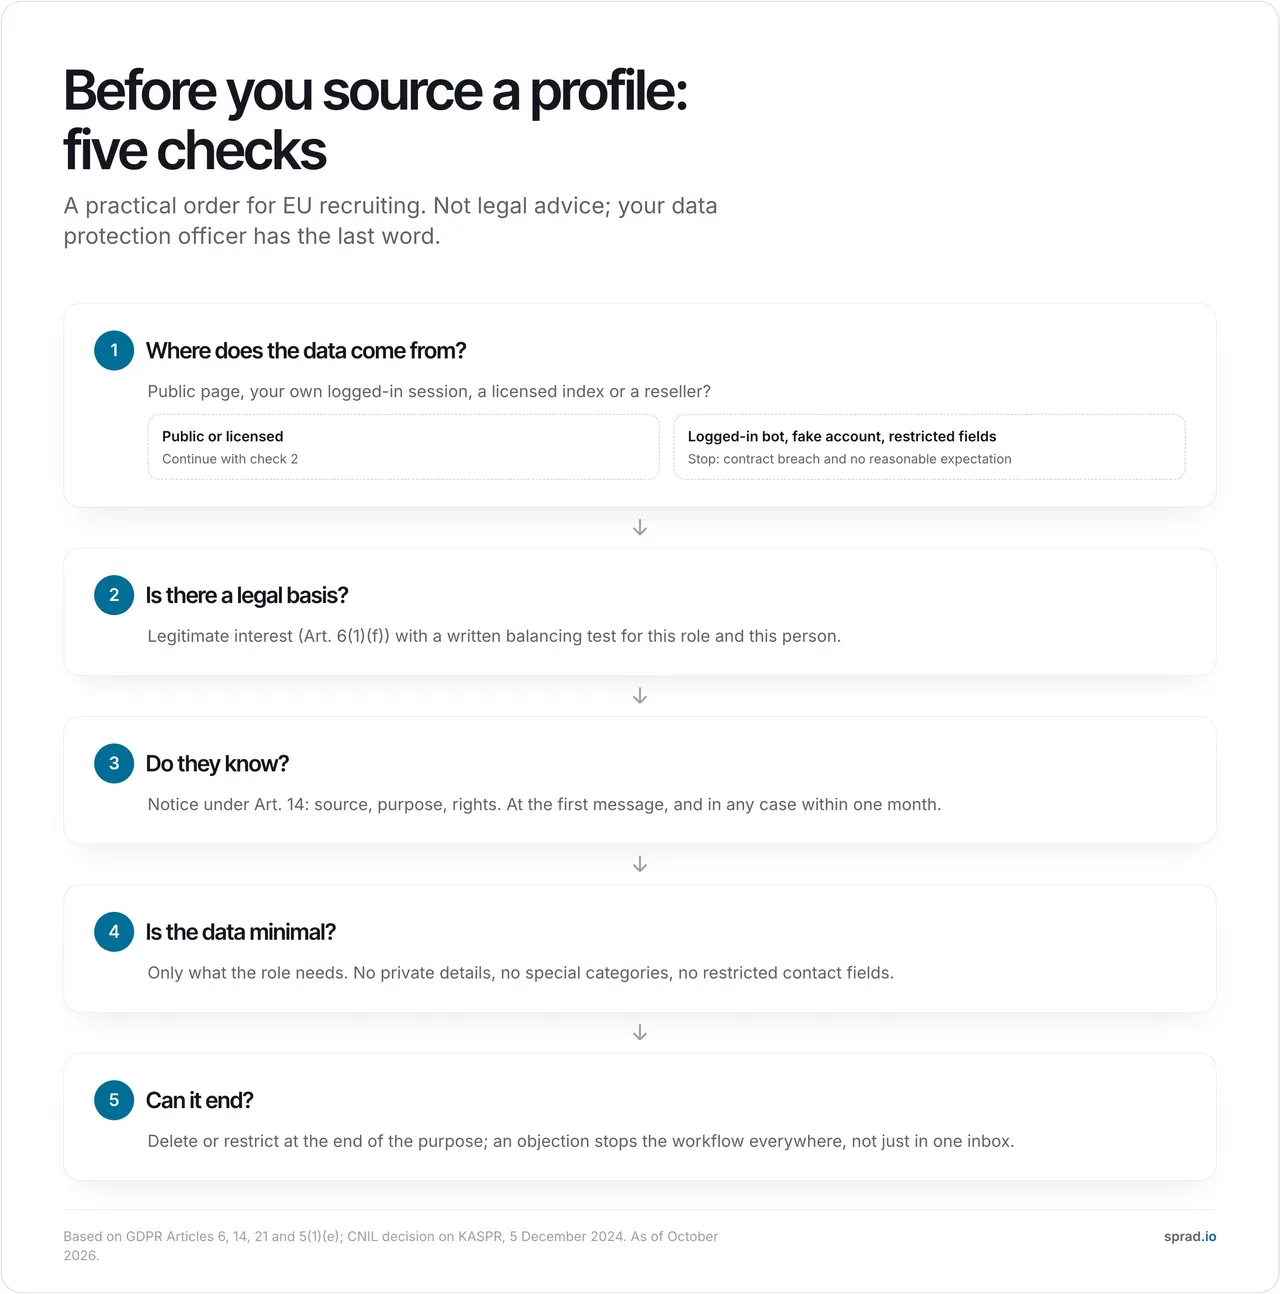
- Choisir d'abord la source. Privilégiez vos propres recherches dans le navigateur, un ATS ou un CRM, ou un outil qui vous dit d'où viennent ses données. Évitez tout ce qui a besoin de votre mot de passe pour tourner en arrière-plan.
- Rédiger une fois la mise en balance par poste. Trois lignes : pourquoi ce poste nécessite du sourcing, pourquoi ces personnes conviennent, pourquoi les données utilisées ne dépassent pas le nécessaire.
- Enregistrer moins de profils. N'enregistrez que les personnes que vous contacterez. Chaque personne que vous stockez devient une fiche soumise à des obligations d'information et de conservation.
- Mettre l'information de l'art. 14 dans le premier message. Indiquez qui vous êtes et votre entreprise, la source ("votre profil professionnel public"), la finalité, la durée de conservation des données et comment s'opposer.
- Fixer une date de conservation. Par exemple, supprimer les personnes sans réponse après six mois, sauf si elles ont accepté de rester dans votre réseau de talents. La durée est votre choix ; consignez-la.
- Faire de l'opposition un arrêt, pas une réponse. Une seule liste que chaque outil respecte.
Exemple chiffré : une équipe de trois
Hypothèse à titre d'illustration : trois recruteurs enregistrent chacun 40 profils par semaine. Cela fait 120 nouvelles fiches par semaine, environ 520 par mois. Si toutes sont stockées sans contact, vous devez 520 informations selon l'art. 14 par mois et gérez 520 dates de conservation. Si vous n'enregistrez que les profils que vous contacterez, disons la moitié, et placez l'information dans le premier message, l'étape d'information ne coûte rien de plus et le vivier conservé diminue de moitié. L'étape de conformité qui économise le plus de travail consiste à stocker moins de personnes.
Le coût est tout aussi concret : un poste recruteur restreint pendant une recherche fait perdre des jours, et un poste coûte de l'argent réel. Les grilles tarifaires publiques situent un seul poste LinkedIn Recruiter Lite à environ 140 $ par mois avec un contrat annuel (vérifiez la page de tarifs actuelle de LinkedIn avant de vous y fier).
| Méthode | Exemple | Risque | Pourquoi |
|---|---|---|---|
| Lire et noter à la main quelques profils | Ouvrir 20 profils pour un poste, en enregistrer 8 | Faible | Petit, propre au poste, facile à justifier et à informer |
| Outil de recherche sur un index sous licence ou du web public | Recherche IA qui renvoie des profils avec des justifications | Faible à moyen | Dépend des sources du fournisseur ; vous restez responsable de traitement pour ce que vous enregistrez |
| Export en masse depuis une extension de scraping | Plug-in de navigateur exportant les résultats de recherche en CSV | Élevé | Enfreint les règles de LinkedIn, collecte sans finalité par personne, construit une base que vous ne pouvez pas expliquer |
| Bots avec des comptes connectés ou de faux comptes | Visites automatisées à grande échelle, profils en rotation | Très élevé | Le schéma que LinkedIn poursuit en justice ; les autorités considèrent comme illicite une collecte allant au-delà de ce qui est raisonnablement attendu |
Quels outils et modèles aident ?
Vous avez besoin de trois courts documents, et aucun ne nécessite de logiciel particulier :
- Modèle de mise en balance (par poste) : finalité, nécessité, incidence sur la personne, garanties, décision et date.
- Texte de l'art. 14 pour le premier message : "J'ai trouvé votre profil professionnel public et pense que vous pourriez correspondre à notre poste ouvert X. Nous conservons votre nom, votre fonction, votre employeur et le contenu du profil au titre de l'intérêt légitime (art. 6, par. 1, point f) du RGPD) pendant 6 mois maximum. Vous pouvez vous opposer ou demander la suppression à tout moment en répondant à ce message ; notre politique de confidentialité est disponible à l'adresse [lien]."
- Registre des oppositions : une seule liste, vérifiée avant chaque envoi.
Posez par écrit six questions à chaque fournisseur de sourcing : D'où viennent les données ? L'outil se connecte-t-il avec mon compte ou utilise-t-il de faux comptes ? Quels champs collecte-t-il, et respecte-t-il les paramètres de visibilité ? Où les données sont-elles hébergées ? Proposez-vous un contrat de sous-traitance des données ? Puis-je tout exporter et tout supprimer ?
Quelles erreurs éviter ?
- Croire que "public" clôt la discussion. La CNIL a sanctionné KASPR précisément pour ce type de collecte.
- Tout exporter "au cas où". Une base sans finalité par personne ne se défend pas.
- Envoyer l'information de l'art. 14 des mois trop tard. KASPR a informé les personnes quatre ans après le lancement et a été sanctionné.
- Considérer un rebond ou une désinscription comme la seule opposition. Elle doit atteindre chaque outil et chaque liste.
- Utiliser des données de scraper pour enrichir des candidats dans votre ATS sans vérifier la source. La fiche hérite du problème.
- Se passer du délégué à la protection des données. Une revue de 20 minutes avant le lancement coûte moins cher que tout ce qui précède.
Comment l'IA change-t-elle la donne ?
L'IA facilite le scraping et agrandit le volume, les obligations suivent donc la même échelle. Un agent qui examine 500 profils par nuit crée 500 décisions sur des personnes que vous devriez pouvoir expliquer. Deux points comptent. D'abord, l'information et l'opposition doivent être automatisées en même temps que la recherche, sinon le processus dépasse sa propre documentation. Ensuite, l'AI Act européen classe comme à haut risque les systèmes d'IA utilisés pour filtrer ou évaluer des candidats (annexe III) : moins un outil décide seul, plus la conformité est simple. De son côté, LinkedIn continue de poursuivre les scrapers à mesure que les bots s'améliorent ; les outils qui durent sont ceux qui ne dépendent pas du contournement de ses défenses.
Où Sprad s'inscrit
Sprad développe des logiciels de recrutement depuis sept ans, pour des start-ups, de grandes entreprises, des clients du secteur public et des assureurs, et la protection des données est l'une des premières questions que nous posent les agences et les équipes internes. Atlas, notre outil de sourcing, cherche sur LinkedIn, XING, GitHub et votre propre vivier de talents, vérifie chaque profil individuellement par rapport à vos critères et affiche une justification pour chaque résultat. L'hébergement est en UE, avec des normes de sécurité fixées par des clients grands comptes, du secteur public et de l'assurance, et cela vaut pour l'Europe et les États-Unis. Les personnes que vous invitez dans votre réseau de talents le rejoignent en connaissance de cause, vous conservez un export complet des données brutes, et le réseau reste gratuit après votre résiliation.
Ce qu'un outil ne peut pas faire, c'est rendre un processus licite à votre place. Vous restez responsable de traitement : la mise en balance, l'information et les règles de conservation vous appartiennent, et Atlas prépare tandis que les humains décident. Dans le PeopleSearchBench public (Recruiting), Atlas atteint 73,5 dans notre propre nouvelle mesure, convertie à l'échelle publiée (publié par Lessie, octobre 2026 ; les scores des autres systèmes sont ceux publiés dans le benchmark ; Atlas correspond à notre propre nouvelle mesure avec la procédure de test ouverte du benchmark, convertie à l'échelle publiée ; ce n'est pas une participation officielle). Vous pouvez commencer gratuitement avec 100 crédits par mois, ou utiliser Recruiter Lite à partir de 79 € par poste et par mois ; voir les tarifs et le sourcing actif. Si vous souhaitez garder vos propres données, lisez à qui appartiennent vos données de candidats.
FAQ
Le scraping de LinkedIn est-il illégal en Europe ?
Pas automatiquement, mais il est encadré. Les profils publics sont des données personnelles, il vous faut donc une base juridique (généralement l'intérêt légitime avec une mise en balance écrite), une information selon l'art. 14, une limite de conservation et un moyen de respecter les oppositions. La collecte de données que les personnes avaient restreintes, ou la collecte sans finalité, a été sanctionnée.
Puis-je être banni pour avoir scrapé LinkedIn ?
Oui. LinkedIn interdit les scrapers, les bots et les extensions qui automatisent l'activité, et restreint ou ferme les comptes qui en utilisent.
hiQ v. LinkedIn a-t-il rendu le scraping légal ?
Non. La décision a jugé que le scraping de pages publiques ne viole probablement pas le CFAA. L'affaire s'est terminée par un jugement sur accord contre hiQ, et elle ne dit rien des conditions de LinkedIn ni du RGPD.
Dois-je dire aux candidats que je les ai trouvés sur LinkedIn ?
Oui, si vous conservez leurs données. L'art. 14 exige une information, au plus tard dans le premier message, et dans tous les cas dans un délai d'un mois après la collecte.
Est-il plus sûr d'utiliser un outil que de scraper moi-même ?
Seulement si l'outil est transparent sur ses sources et ne se connecte pas comme vous ni n'utilise de faux comptes. Posez la question par écrit ; vous restez responsable de traitement dans les deux cas.
Cet article donne des informations générales à jour en octobre 2026 et ne constitue pas un conseil juridique. Pour votre propre processus, adressez-vous à votre délégué à la protection des données ou à un avocat.
Jürgen Ulbrich
Jürgen Ulbrich cumule plus de dix ans d’expérience dans la construction et la direction d’équipes et d’entreprises performantes. Expert des programmes de cooptation ainsi que des processus de feedback et de performance, Jürgen a aidé plus de 100 organisations à optimiser leur stratégie d’acquisition et de développement des talents.